
GPT-6 Astra都能操控机器人了,具身智能公司会被“降维打击”吗?
随着近期GPT-6 Astra在机器人控制上展现出亮眼能力,引发了具身智能赛道广泛关注和讨论:通用数字模型是否会直接进入机器人,甚至“降维打击”具身智能公司?与此同时,数据短缺、商业化落地难、泡沫质疑声,仍在困扰这个年轻的行业。
在2026 Inclusion·外滩大会期间,围绕着业内比较关注的问题,众多业内嘉宾展开了讨论。嘉宾们呼吁更理性看待具身智能的发展,少一点过高的期待,多一些耐心。虽然未来行业发展仍然充满了不确定性和挑战,但是大家也满怀信心和希望。
通用数字模型会“降维打击”具身智能吗?
关于GPT-6 Astra在具身智能领域的能力拓展,有的嘉宾认为这是很现实的问题,前沿的通用数字模型公司在人才、资源、技术工程化方面的积累深厚,从通用数字模型延伸去做世界模型或具身智能没有太大的GAP和成本,留给纯粹的世界模型公司或者具身智能公司的时间窗口不会很长,必须在短暂的1-2年之内兑现大众的期望。
也有不少嘉宾相信,通用数字模型并不会“降维打击”具身智能公司,因为数字世界走向物理世界,要面临跨越空间感知、动态交互和跨本体泛化等方面的挑战,这些难度不会因为拥有一个更强的语言模型而自动消失。
(图说:蚂蚁灵波科技CEO 朱兴)
“如果今天OpenAI或者Anthropic下场做自动驾驶,能短时间颠覆特斯拉吗?”在采访中,蚂蚁灵波CEO朱兴以自动驾驶领域作为类比阐述了自己的观点。答案不言自明,短期内是做不到的。他进一步指出,自动驾驶更核心的壁垒是数据。
具身智能赛道真正不可替代的壁垒同样在于数据,包括优质数据的筛选标准和优质数据积累、数据know-how以及优秀的数据管线,这是外部大模型厂商短期无法搭建和赶超的核心优势。
目前具身智能的发展面临着非常大的数据挑战,相对而言,自动驾驶比具身领域更容易采集数据,但是仍然经历了漫长的技术周期,如今L5级自动驾驶的落地,仍需跨越相当漫长的距离。具身智能的发展还处在更为早期阶段,也要穿越技术周期,才能有一个好的发展,大家还需要多一些耐心。
不过朱兴也指出,GPT-6 Astra所演示的在具身智能领域的进步也有其价值,可以提升机器人特定阶段的研发效率,“这对具身的研发来说是一个好的工具支持,但解决的不是根本问题,根本问题玩到最后还是数据。”
(图说:蚂蚁灵波科技首席科学家 沈宇军)
此外,数字世界和物理世界是非常不同的运行、交互环境,对模型能力的需求也不同。蚂蚁灵波首席科学家沈宇军指出,机器人必须在行动过程中持续接收传感器输入,并根据环境实时改变决策,不能简单复刻数字世界处理信息的方式,还是需要发展真正面向物理世界的模型架构与训练方法。“具身可能会走跟数字世界相同的模式,但一定不会走相同的技术路线。”沈宇军说。
基于上述判断,蚂蚁灵波选择了具身原生路线,其LingBot-VA 2.0作为行业首个具身原生的世界动作模型,没有“嫁接”数字世界模型,而是从头开始预训练,通过全新的语义视觉—动作分词器、严格的因果预训练、MoE架构与异步推理机制等创新,让机器人能够“边推演、边行动、边调整”。在行业普遍面临的具身世界模型执行效率低这一问题上,LingBot-VA 2.0能够实现单卡150Hz实时推理效率。
朱兴表示,如今具身智能已经进入到了“百模大战”初期,相比“嫁接”数字世界模型,具身原生路线更难,也需要更高的投入,但拥有更高的上限。“蚂蚁灵波是行稳致远长期去做(具身智能),也会比较早地选择一些投入更大、风险更高的路线,因为这个路线是要长期发展的,上限是更高的,我们希望灵波能穿越几个周期。”
不要单纯看数据的量,更关键的是看质量与分布
数字通用模型可以依托海量互联网文本数据开展训练,但具身智能天然面临数据短缺问题:互联网数据大多是文字、图像这类静态信息,缺少物理世界里机器人真实交互产生的感知、力反馈、动作与环境联动数据,而物理场景实验成本高、安全约束多、场景难以复刻,很难像爬取网页那样低成本大规模采集,导致具身智能很难获得足够丰富且高质量的真实交互数据。
面对数据层面的挑战,大家目前是八仙过海,各显神通。虽然选择的路线可能不太一样,都有自己独特的数据配方,但是有一点比较明确,能否取得好的模型智能,不能单看数据的量,还要看数据的质量和多样性。
(图说:苏度科技联合创始人、CEO 韩铮)
苏度科技联合创始人、CEO韩铮认为,真实世界的数据采集效率有限、质量也不总是稳定,仿真因此是绕不过去的一环。苏度科技长期押注仿真,希望通过大规模强化学习,让机器人在不同物体和环境中获得泛化能力。但他同时强调,仿真与真实数据并不是非此即彼,最终更可能形成分层和组合,关键还是需要用多样性、高质量的数据去进行训练,才能达到一个比较好的效果。
(图说:破壳机器人创始人、清华大学交叉信息研究院助理教授 许华哲)
破壳机器人创始人、清华大学交叉信息研究院助理教授许华哲指出,当前行业对数据量本身存在一定程度的高估。“一百万小时”“几百万小时”的数据并不意味着就能训练出更好的模型。数据规模之外,质量、分布和训练方式可能更加重要。
朱兴也分享了蚂蚁灵波对数据的一些思考判断:
首先,数据规模固然重要,但不能只追求数据的量,更要关注数据的质量与分布,其中数据分布更是模型厂商最核心的know-how。行业常将模型训练比作“炼丹”,炼丹背后也就是数据的配方。
其次,仿真数据、真机数据、Ego(egocentric,第一人称视角)数据等不同类型的数据,在训练的不同阶段具备各自的价值。比如,仿真数据更多适用于训练中后期,针对特定任务做强化优化,提升任务成功率。很难指望仿真数据在预训练阶段产生巨大价值,如果仿真就能够产出大量高质量预训练语料,意味着仿真能力已经足以直接控制机器人,模型训练也就不再是难点。
最后,不能简单划定一个不同数据源之间的配比,不同数据在不同训练阶段能起到不同的作用。整体上可以将模型训练分为预训练、中间训练、后训练几个阶段,预训练阶段重在实现场景泛化,会优先选用无本体约束的数据、互联网视频这类便于做规模扩展的数据;而到后训练阶段,目标是提升特定场景、特定任务的实际成功率,越贴近真实机器人本体采集的数据,价值就越高。这也是项目落地前依然要开展数据采集的原因,需要让模型适配机器人自身构型,适配真实业务任务与现场环境。
据悉,蚂蚁灵波新一代具身基座模型LingBot-VLA 2.0在预训练阶段融入6万小时高质量真实物理数据,覆盖17个主流机器人品牌的20种机器人构型,并扩展对头部、腰部、末端执行器及移动底盘等自由度的支持。在构型泛化、自由度支持和落地效率等方面实现显著提升。
当前关于数据的一个共识是,具身智能领域的数据飞轮还没有转起来,还在冷启动期。蚂蚁灵波首席数据科学家黄用韬表示,数据飞轮尚未真正转起来的一个关键原因,是进入真实生产和服务场景的机器人还太少。大量机器人仍用于科研、数采或展示,真实工作中的失败与反馈没有充分回流。
数据飞轮的转动需要产业多方“协同突围”,蚂蚁灵波致力于联合生态伙伴构建一个可以让数据回流的数据网络,让模型在异常数据反馈中不断迭代优化成长,进一步推动具身智能规模化落地发展。
具身智能要在真实商业场景中淬炼成长
具身智能虽然整体上还存在泛化性、数据缺失的挑战,但是随着模型技术、数据方面的不断发展,业内也开始探索商业化落地。
不过,以具身智能为代表的物理智能,与大语言模型这样的数字智能相比,其试错成本更高,容错空间更低。因为前者每一次尝试都作用于真实物理世界,错误会直接转化为硬件损耗、安全事故或不可逆后果,而后者还可以在虚拟的数字空间里“重来一次”。
所以可以看到,具身智能的商业化需要走得更稳健一些,慢工出细活。业内大多先从药房、仓储物流、工业巡检、家庭服务等垂直场景小切口落地,在真实环境里积累数据、经验、打磨可靠性,再逐步向更复杂的场景延展。这条路走得慢,但每一步都要踩在实地上。
整体来看,具身智能落地应用主要有两大场景,一类是生产力场景,另一类是进入家庭的生活服务场景。后者会面临包括技术、伦理、法规等多方面的挑战,也承载着业界更大的期待。 具身智能从一个Demo进入产业落地,需要跨越的,远不止一道技术的坎。
韩铮首先强调的是成功率和泛化性。在真实商业场景里,大量工业任务第一次执行就必须接近100%的成功率;与此同时,它还要能够适应不同物体和环境,不能每进入一个新场景,都依靠大量后训练重新“过拟合”一次。
在沈宇军看来,行业还容易陷入另一个误区:把商业化几乎全部归因于模型性能。在真实场景中,客户最终购买的不是一个模型指标,而是一套能够工作的系统。具身智能是一个复杂的系统工程,模型只是其中一环,不要太过高估模型能力带来的影响。真正商业落地,要综合考虑硬件、模型、系统鲁棒性、部署方式和最终ROI,而不能把所有场景问题都归结为“模型还不够强”。
朱兴认为,即使机器人的能力还处于“童年”阶段,也需要下场干活,否则学习过程本身就是不完整的。一个公司的技术能力需要在真实商业场景中淬炼成长,“只有付费的商业化,才能迎接更真实的考验。商业化是公司往前走非常重要的核心能力,再好的技术都是通过不断迎接商业化的挑战沉淀下来的,不然不可能最 先进、最 高效。”
只不过具身智能商业化落地的场景选择需要谨慎,可以优先从安全性较高、环境较可控、任务链条较短的领域开始。
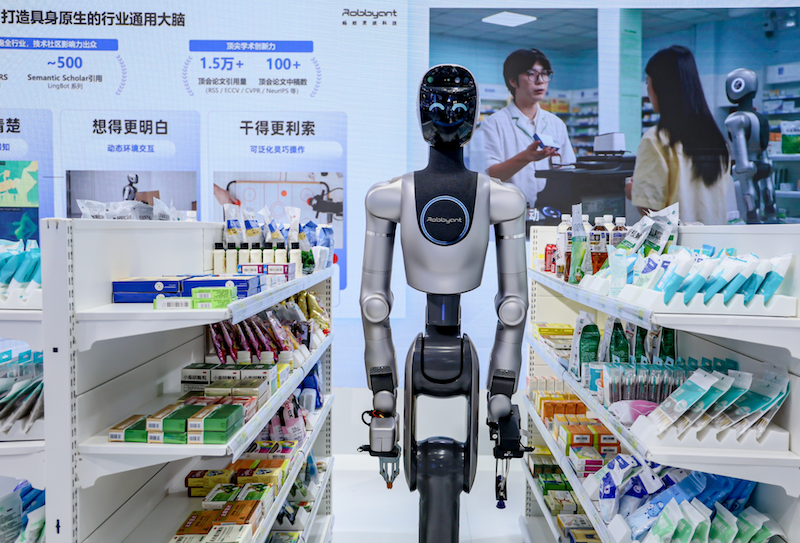
(图说:蚂蚁灵波与国大药房联合打造的智慧药房亮相2026 Inclusion·外滩大会)
在外滩大会展区,可以看到,蚂蚁灵波将同一套通用大脑搭载到不同形态的机器人上,让它们分别进入药房、物流和工业场景。在智慧药房中,机器人在仅80厘米宽的货架间精准移动、避障,完成接单、药品识别、拣选与交付,无需改造原有货架和门店布局。相关方案已在国大药房零售门店部署。面对柔性包裹和规格、姿态不一的工件,物流分拣与工业上下料演示也在检验这套大脑适应不同构型和任务的能力。
蚂蚁集团一直围绕生活服务深耕了二十多年,灵波科技是蚂蚁集团在未来物理智能时代生活服务方面的战略延伸,最终追求的是在物理智能时代,如何更好地服务于人,甚至如何更好地在家庭中服务于人,这些都离不开具身智能。而灵波科技与蚂蚁本身在生活服务的积累也可以协同共振,“当具身智能持续发展的时候,本身蚂蚁集团在生活服务上就有长期的用户、场景和数据的积累,将来完全可以跟灵波有更多的‘会师’。”朱兴说。
可以看到,蚂蚁灵波以终为始,选择的场景兼顾商业价值与未来长远目标。比如,智慧药房这一试点场景,一方面有需要,会产生商业价值。另一方面,药房是典型的生活服务场景,作为技术牵引,对未来进家庭的探索也有帮助。
机器人不一定非要像人,也不必非要替代人
机器人一定要像人吗?这是一个蛮有意思的话题。
人类历经数百万年进化,沉淀出许多与生俱来的本能能力,比如感知,而这类能力恰恰是具身智能最难攻克的环节。同时,人类大脑还演化出“快思考”与“慢思考”的双系统机制,前者负责直觉与本能反应,后者承担理性分析与深度推理。具身智能的发展确实可以从大脑结构和人类进化中汲取灵感,例如大脑与小脑的分层设计——大脑统管高级认知与决策,小脑则专司运动协调与自动化控制。然而,人类进化中还有更多机制难以被简单模仿或照搬,具身智能仍需走出自己的路。
朱兴认为,人是非常高阶的智能,具身智能没有必要非去学人,而且也学不来。比如人的皮肤,包括整个脉冲神经网络的工作原理,这么多神经元工作,却保持很低的能耗,这些都是具身智能难以模仿的高阶智能。此外,人还有更高阶的安全方面的智能,比如,人怕死,这会影响非常多的行为。
“我觉得机器人没必要替代人,长得像人,什么都要像,没必要。 我们更多是看具身智能作为一个新的技术,能够创造什么样的社会价值与商业价值。过去比较火的词是‘第一性原理’,‘第一性’就是人形机器人必须更像人,我不觉得是一个科学的方法。”朱兴强调,具身智能发展的落点还是要看所创造的价值。
整体来看,具身智能的发展还在非常早期的冷启动阶段,模型路线百花齐放,没有形成共识走向收敛,而且缺乏数据,数据飞轮没有转起来,商业落地还在摸索中,也面临一些泡沫的质疑声。同时也可以看到,随着模型能力与数据的发展,这两年已经有一些商业化落地,从业者对长期发展也满怀信心。随着更多从业者专注于价值实现,更多机器人开始走入产业和生活,属于具身智能的故事才刚刚开始。

