
CCF HPC 2026观察:E-HPC走向科研计算新范式——阿里云携手AMD,算力底座如何接住Agent化科研
10月17—20日,第二十二届CCF全国高性能计算学术大会(CCF HPC 2026)在深圳国际会展中心举行。大会以“超智深融 算力圳浓”为主题,聚焦国产算力自主创新、超智深度融合、算力互联互通、绿色算力体系建设等热点,汇聚20余位中外院士领衔的专家学者及500余位高性能计算领域专家学者。
规模之外,更值得关注的是大会释放出的产业信号:科研AI化推进两年,真正卡住科研人员的往往不是模型,而是数据准备、环境配置、任务编排这些“脏活累活”。
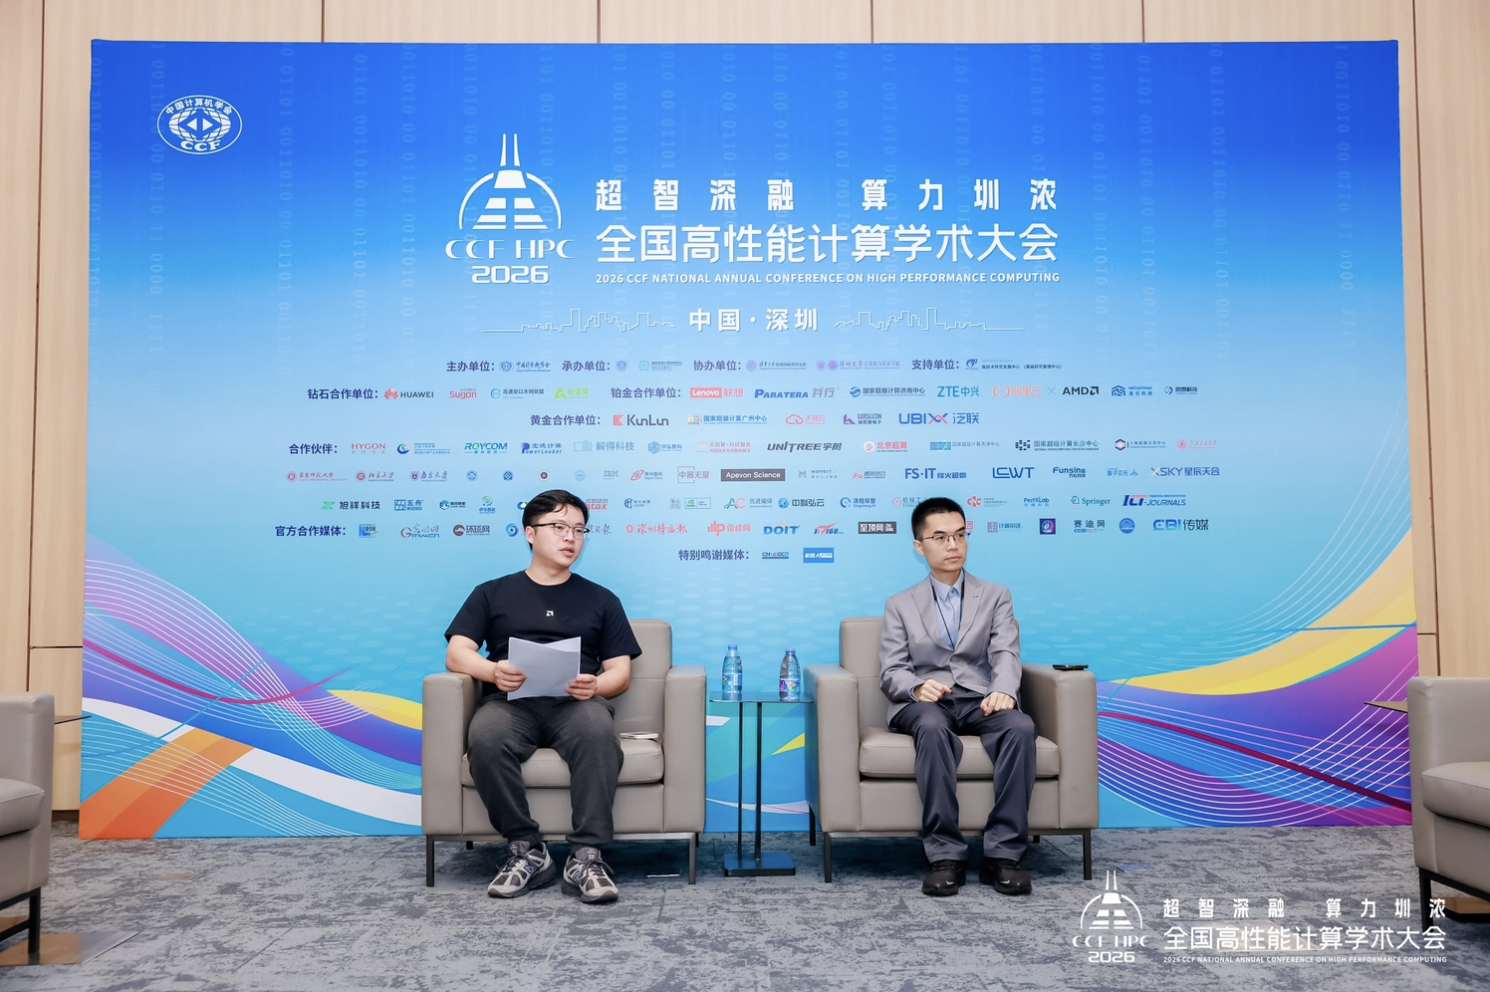
右:阿里云智能集团高性能计算&性能加速负责人游亮
左:AMD大中华区高级解决方案架构师余伟飞
阿里云智能集团高性能计算&性能加速负责人游亮在《阿里云E-HPC智能体——全面加速科研计算新范式》主题报告中提出,科研计算正在从“人驱动工具”走向“人定义目标、目标驱动智能体”的新范式转变。同期,阿里云携手AMD推出为HPC应用设计的CPU优化实例hpc9a,采用第五代 AMD EPYC™(霄龙)9005 系列处理器,面向泛工业仿真、电子设计自动化等高性能计算需求。
AMD大中华区高级解决方案架构师余伟飞在采访中则补充了另一面:当AI走向规模化推理和Agent应用,CPU在任务编排、数据处理与通用计算中的作用正在被重新看见。一个负责执行链,一个负责算力底座,HPC的竞争逻辑正在换挡。
E-HPC打法升级:从提供算力到融合算力优势的Agent驱动的科研执行平台
今年E-HPC最大的产品变化,是从云上科研算力提供者走向Agent驱动的科研执行平台。游亮在采访中给出的判断很直接:过去科研人员要自己准备数据、配置环境、调用工具、分析结果;现在只需给Agent定义研究目标和验收标准,Agent自主理解目标、规划任务、执行作业,并根据执行反馈进行调参和优化。客户最先感知到的不是某个峰值指标,而是科研效率的大幅提升。
这背后不只是增加一个Agent入口。阿里云E-HPC智能体平台支持行业Agent通过Skills、MCP、OpenAPI等方式直接调用科研算力,由Agent完成理解目标、规划任务、调用工具和反馈再规划的闭环,E-HPC执行层负责作业编排与异构资源调度。目前平台已在具身智能、生命科学、CAE仿真、量化研究等场景形成多个行业智能体,支撑某具身智能头部企业打通“采—标—训—仿”数据闭环,并为某生命科学智能体平台编排的140余项Skills提供弹性算力底座。
从这些信息看,E-HPC并非单一产品形态,而是行业Agent层与执行层的组合。面对“算力底座还是端到端产品”的平衡问题,游亮的回答是两者都会提供:已有Agent的客户可通过Skills、MCP、CLI、OpenAPI、SDK直接调用E-HPC算力底座;尚未建设Agent的客户,则可以使用阿里云联合合作伙伴提供开箱即用的行业Agent和Skills。未来三到五年,E-HPC的优先级包括继续深化具身智能、生命科学、CAE、EDA、量化等行业Agent与专家Skills能力,建设Skills市场,并协同高性能计算、AI训练推理、通用、容器、沙箱等实例完成智能调度。换句话说,E-HPC想做的不是单点工具,而是把科研目标翻译成可执行任务的平台层。
如果把平台能力落到行业,阿里云E-HPC目前重点打磨的是三条方案线。面向EDA芯片设计,E-HPC混合云可以无损对接LSF、Slurm、PBS等主流调度器,按队列负载自动扩容、作业结束自动缩容,让流片前的仿真验证不再长时间排队;针对STA、PR这类大内存作业,则用大内存HPC优化实例来承接。面向AI4S与生命科学,E-HPC Instant应用市场预集成AlphaFold3、OpenFold3、RFDiffusion、GROMACS、GATK等工具,客户自有的科研Agent可以通过CLI、API或Skill直接调用算力,把药物发现、基因分析等流程串起来。面向具身智能,HPDA Robotics把采集、管理、标注、训练、仿真、推理做成一条数据闭环,内置APAK加速引擎,多模态数据处理的性价比可提升2.1至5倍。三套专属方案共享同一张弹性算力网络和同一套调度、存储与安全能力,既能开箱即用,也能平滑接入客户现有环境。
hpc9a,高性能计算负载下的新选择
阿里云的新实例hpc9a,采用第五代 AMD EPYC™(霄龙)9005 系列处理器,面向泛工业仿真、电子设计自动化等高性能计算需求,覆盖具身智能、生命科学、CAE、EDA芯片设计、量化金融等场景,对比上一代hpc8ae在算力、内存带宽、内存容量等方面都有了长足的进步。余伟飞在采访中介绍,EPYC 9005系列的变化体现在核心性能、内存与I/O等方面。Zen 5内核采用完整512位数据通路,为AVX-512向量计算提供支持;不同型号在频率和核心数量上各有侧重,EPYC 9005系列支持最多12通道DDR5内存通道、单路系统最多128条PCIe 5.0通道及CXL 2.0。具体型号、平台和云实例开放的功能,应以对应官方说明为准。
“开箱即用”的调优能力也值得注意。除了提供一键调优模板,阿里云E-HPC Agent还会面向主流HPC软件提供一键优化Skills,根据用户需求自主选择最匹配性能和成本的实例类型,并自动寻找最优运行参数进行计算。当这类能力在生产环境中规模化落地后,选型和调优有望更多从依赖专家经验转向平台化能力。
CPU被重新看见,算力配比与开放生态成为关键词
过去两年,算力几乎被等同于GPU。余伟飞在采访中判断,CPU的价值不是“回归”,而是“被重新看见”。当AI从训练走向规模化推理和Agent,模型推理只是生产系统的一环,围绕它的是编排服务、数据库、缓存、API网关、中间件和工具调用,这些环节中的许多服务运行在CPU上,资源需求受并发用户、Agent任务量和具体实现影响。CPU既是AI服务器主机节点,也承载适合在CPU上运行的推理负载,还要承接AI带动的数据处理、数据库和业务系统需求。
面对科研计算Agent化、AI化,CPU的角色正在从“纯算力”转向“算力+编排+数据吞吐”。余伟飞进一步介绍了AMD侧的三个设计方向:算力上,Zen 5向量计算能力和高主频型号面向流体、结构、分子动力学等仿真求解,结合具体实例配置评估并行求解性能;编排上,Agent的任务调度、沙箱运行、工具调用和工作流状态管理等环节需要通用计算资源,高核心密度处理器可为并发任务提供支持,实际承载能力仍需结合内存、I/O和任务特征评估;数据吞吐上,EPYC平台的内存带宽和I/O能力有助于缓解数据搬运瓶颈。软件层面,AMD提供编译器、数学库和面向AI推理的CPU优化。
阿里云侧则按工作负载匹配算力。游亮接受采访时表示,阿里云作为云计算提供商,会为不同工作负载提供最合适的算力:面向HPC任务,提供了具备高主频、高内存带宽、大内存特性的HPC优化实例,满足CAE、EDA等计算密集和大内存负载;面向Agent编排等任务,提供了通用、容器和沙箱实例,让大规模任务编排响应更快、成本更低;这些实例基于阿里云自研CIPU2.0架构,支持VPC、eRDMA网络和CPFS并行存储,大幅提升数据吞吐量、减少节点间通信开销,构成弹性算力网络供E-HPC和Agent进行调度与编排。CIPU2.0支持卸载网络和存储的虚拟化开销,支持eRDMA提供低延迟节点间通信,让CPU资源尽可能留给计算本身。双方在数据吞吐层形成互补:EPYC平台提供CPU的内存带宽和I/O能力,阿里云通过CIPU2.0、eRDMA和CPFS并行存储提升吞吐、降低通信开销。
在具体产品组合上,高主频型号适合AI服务器主机节点和对单核性能敏感的业务,高核心密度型号适合承载大量并发的Agent服务和云原生应用。双方合作的重点之一是提前布局。阿里云会分析云上客户实际工作负载对主频、Cache、内存容量和带宽的需求,与AMD围绕平台适配与应用优化开展技术交流。余伟飞谈到的合作价值,涉及应用适配、迁移支持与平台选择,具体效果仍需结合软件依赖和部署条件验证;在生态锁定与迁移成本成为企业顾虑的背景下,他强调AMD的x86兼容、CXL开放标准、OCP开放计算社区优化和多家OEM/云伙伴选择,并把开放路线的意义概括为“把选择权交给客户”。
放到更长周期看,HPC与AI融合的下一阶段,与其说是GPU与CPU谁替代谁,不如说是“配比”与“闭环”的竞争。E-HPC通过Agent把科研目标智能转成执行流,hpc9a用系统性升级承接负载分层,AMD通过开放生态为应用适配与平台选择提供支持。谁能把复杂性留在平台侧,让科研人员更专注于科研问题本身,谁就更可能在这一轮HPC体验升级中占据主动。

