
FoxJack™ X1:给机器人大小脑做减法
在具身智能的工程实践中,一个普遍的做法是"双机并联":x86主机运行大脑,负责环境理解、任务规划与多模态推理;嵌入式AI模组承担小脑,负责实时运动控制。这套架构看似各司其职,实则隐患不少——两套硬件意味着两份BOM成本、两个散热与供电系统,跨机数据传输引入不确定性延迟,系统同步与联调更是拉长了开发周期。当具身智能进入规模产品化阶段,这些隐形成本会被成倍放大,直接吞噬整机毛利与交付节奏。
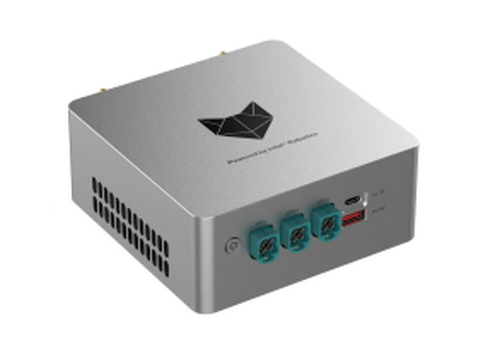
针对这一行业痛点,9月23日,由英特尔与科通技术联合开发的具身智能开发套件FoxJack™ X1在"2026英特尔技术创新与产业生态大会(Intel Connection 2026)"上正式发布,具身智能开发套件FoxJack™ X1是基于英特尔® 酷睿™ Ultra 300 系列处理器(Panther Lake)异构算力平台开发,让机器人厂商第一次有机会对主控架构彻底做一次"减法":一台125×125×57.5毫米、65W整机功耗的设备,取代"x86主机+AI模组"的两套系统、两套散热供电与它们之间的全部线缆。这台整机不仅装下了最高180 TOPS(INT8稠密)的AI算力,还集成了机器人本体所需的完整接口——12路GMSL2摄像头接入、EtherCAT工业以太网与CAN FD总线一应俱全,感知、决策、控制在同一台设备内闭环完成。
减法的底气来自芯片级融合。FoxJack™ X1基于第三代英特尔® 酷睿™ Ultra 处理器家族,单芯片集成CPU/GPU/NPU三重算力:CPU负责逻辑调度与系统管理,锐炫集成显卡与NPU承担AI推理,英特尔® TCC时间敏感计算与TSN网络同步能力保障实时任务确定性。统一内存架构让感知结果与运动指令通过共享内存直接传递,数据无需跨机搬运,延迟与抖动被压缩到最低。
对于追求极限性能、搭载Thor或RTX独立显卡的高端人形方案,FoxJack™ X1同样有它的位置:作为运控小脑,offload部分大脑计算,接管实时控制与部分感知任务,让昂贵的独立GPU专注于大模型推理——整机算力配比更合理,总体成本显著降低。传统机器人为了隔离实时与非实时任务而额外配置的实时MCU甚至多颗CPU,也可以省掉:intel® Panther Lake的虚拟化能力支持单系统核心隔离与多系统虚拟化隔离两种框架,实时运动控制与上层应用在同一SoC上安全隔离运行,器件数量、板级面积与功耗预算同步下降。
减法的前提是确定性不缩水。这一代处理器首次为机器人等边缘场景进行了嵌入式与工业级认证,支持宽温运行、确定性性能与24×7全天候可靠性——在工厂车间与户外作业的真实环境里,主控平台稳得住,减法才站得住。软件层面同样减得彻底:FoxJack™ X1预装的英特尔具身智能机器人软件开发套件(Robotics AI Suite)集成Preempt-RT实时内核,预装ACT、ORB-SLAM3等典型工作流与LLM/VLM/VLA参考演示,支持OpenVINO™模型优化;平台支持Windows与Linux双系统,一套硬件覆盖研发与量产两种环境;工业级使用条件下生命周期最长可达10年,整机产品在整个生命周期内不必担心主控断供。
具身智能的竞争,最终会从"谁的参数更漂亮"转向"谁的系统更简洁、更可靠、更可控"。FoxJack X1以一台整机替代多机堆叠,以芯片级融合与虚拟化替代冗余器件,为机器人本体厂商提供了一条降低系统复杂度、缩短开发周期的现实路径——减掉的是负担,留下的是竞争力。

